馬可夫架構 (Markovian Framework)
強化學習 (Reinforcement Learning) 的理論基礎建立在馬可夫性質之上,並透過馬可夫決策過程將其轉化為可計算的模型。馬可夫架構將複雜的決策問題簡化為單步轉移的機率映射,為後續的價值函數推導提供了理論前提。
馬可夫性質 (Markov Property)
馬可夫性質是描述隨機過程的一種無記憶特性。其核心定義為:當前狀態 已經包含了影響未來的所有相關資訊,因此未來的狀態演化僅取決於當前狀態,而與過去的歷史路徑無關。在數學上,這表示為條件機率:
這種性質極很大的簡化了系統建模,使模型不用回溯歷史數據就可預測未來。
有限馬可夫決策過程 (Finite MDP)
所謂「有限」是指系統中的 狀態空間 (State Space) 、動作空間 (Action Space) 以及 獎勵空間 (Reward Space) 均由有限數量的元素組成。在學術與工程應用中,有限限制 (Finite Constraint) 至關重要,因為它確保了系統的轉移機率與期望獎勵可以被完整地表達為矩陣形式,進而使數值演算法(如動態規劃或強化學習迭代)具備收斂性與計算上的可行性。
有限馬可夫決策過程由五元組 完整定義。其中 代表 轉移機率函數 (Transition Probability Function), 為 報酬函數 (Reward Function),而 則是調控未來回饋權重的 折扣因子 (Discount Factor)。
決策流程

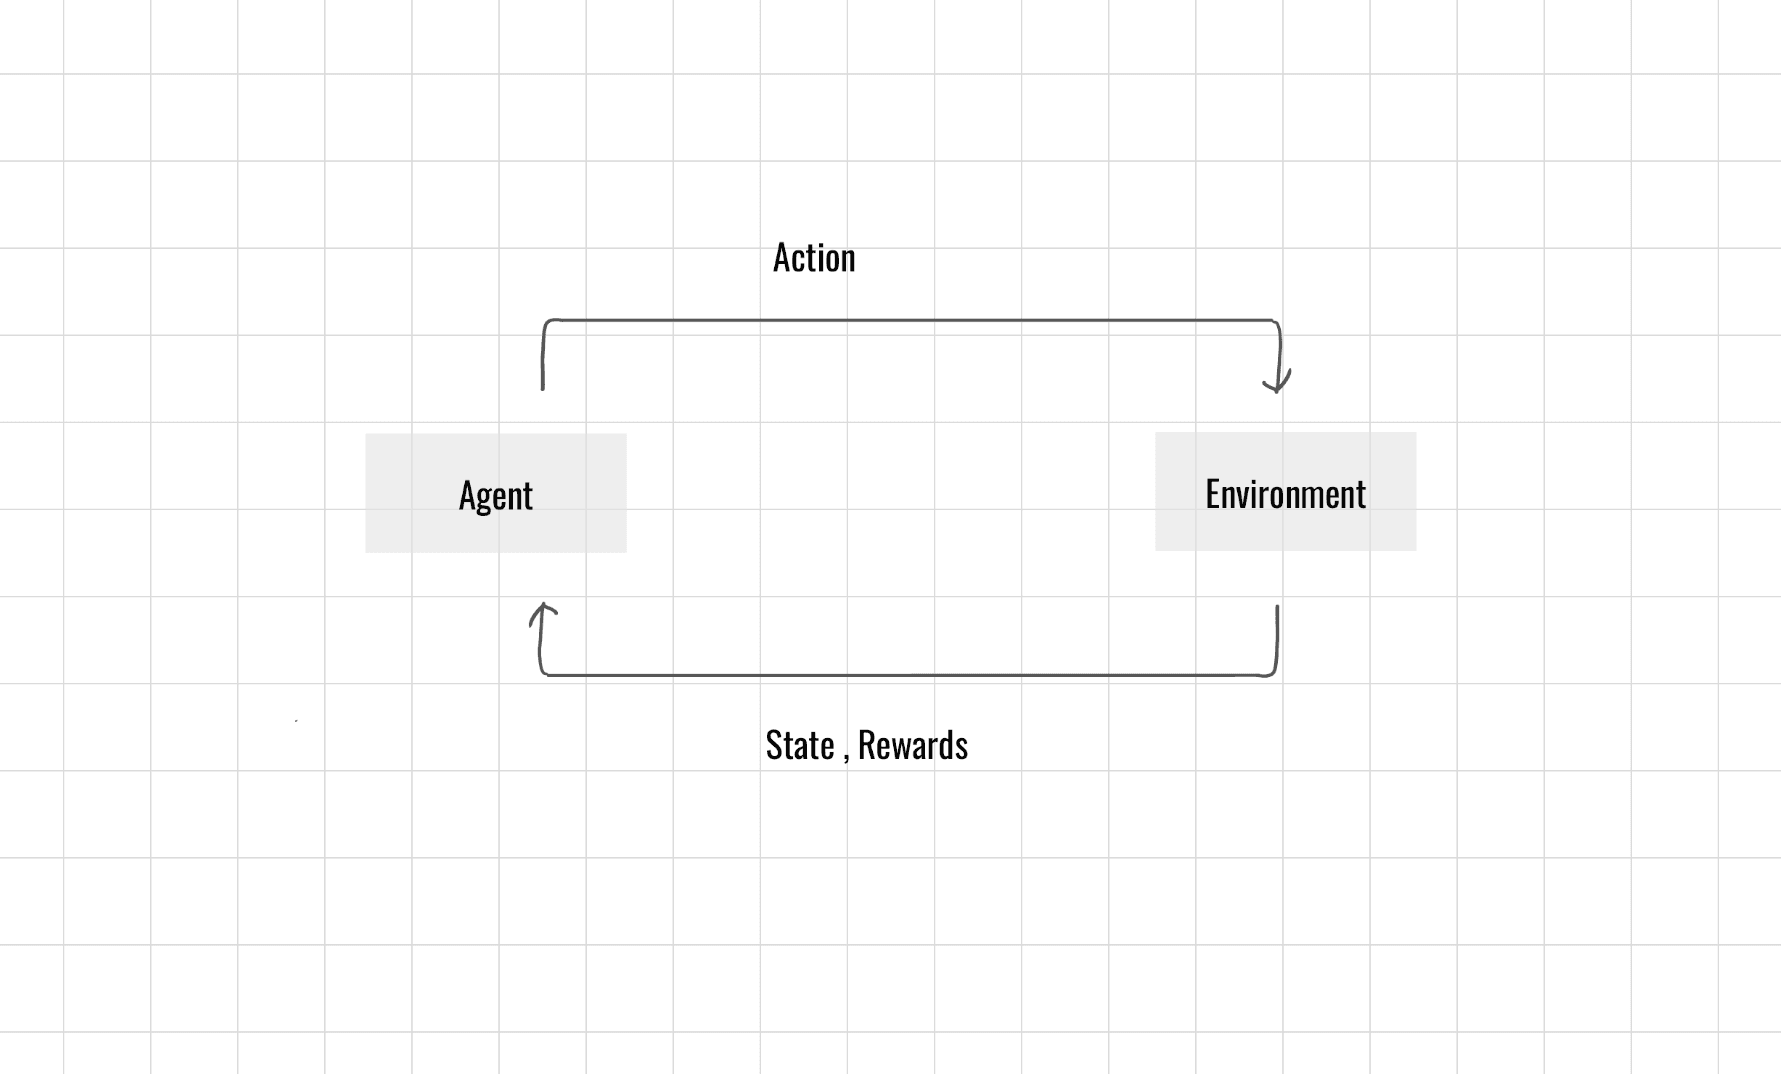
在有限馬可夫決策過程中,智能體 (Agent) 與環境 (Environment) 於 離散時間 (Discrete Time) 進行互動。於每個時間步 ,智能體觀察當前環境狀態 並基於該狀態選擇動作 。環境接收動作後,回應數值獎勵 以及下一個狀態 ,促成連續交互過程。整體互動軌跡可表示為:。
轉移機率函數(Transition Probability)
轉移機率函數也稱為動態函數,這裡以P表示,包含狀態S、獎勵R、動作A狀態集合,在同一次行動中的機率將映射在0到1之間。

動態函數描述下一狀態與獎勵只依賴當前狀態與動作來考慮,而這個動態函數的轉移機率則可以表示為以下

該公式描述在狀態 下執行動作 ,並且轉移到下一個單一狀態 的機率,獲得獎勵 的機率
機率分布(probability distribution)
理解動態函數的轉移機率後,再來是延伸機率論中的機率分布的表示方法
聯合機率方法表示為:

該公式描述為當滿足 狀態動作下,轉移至下一個動作所獲得的獎勵機率總和為1,需要留意這裡的是以發生單一事件,而轉移至下一個可能發生的所有狀態與獎勵,因此將所有的事件機率加總機率將等於1。
邊際機率
邊際機率與聯合機率不同,這部分不考慮所有的狀態s',只考慮一個狀態下的所有獎勵機率,因此這裡將所有可能的獎勵值 的機率加總起來,而機率總和等於1

狀態轉移機率分佈概念

期望獎勵 (Expected Reward)
簡單回顧一下期望值的觀念,期望值為一個連續事件機率下的獎勵平均作為價值評估,表示為
在有限馬可夫決策過程中,若考慮不同條件下的參數,獎勵的期望值在兩個參數時表示為狀態-行動 在三個參數時表示為 狀態-行動-未來狀態
狀態-行動
若計算當前 的獎勵期望值表示為

在狀態 採取動作 時,對所有可能的 和 做加權平均,求得期望值
一個例子
假設
- ,且
可以留意到這裡在狀態和動作下的獎勵他是一個整體得機率分佈,因此他的下一個狀態機率總和應等於1
狀態-行動-未來狀態
當期望獎勵固定下一狀態 ,則已知 <span class="paren">(s'),因此只考慮這個 <span class="paren">(s') 下所有可能的獎勵 <span class="paren">(r)。這是條件分布的概念,在邊際機率討論單一變數的情況下,分母是條件機率的總和,必定 < 1

分母 是轉移到 的機率總和 分子 是到達 並獲得不同獎勵的加權後的總和
一個例子
假設
分母是s'狀態轉移機率
計算 的獎勵期望值
延伸思考,這個例子我們可以確定 的發生機率等於 0.5 裡面有兩個獎勵的機率,我們可以推測 的發生機率必定等於 0.5 ,但是裡面的獎勵集合數目與獎勵未知。