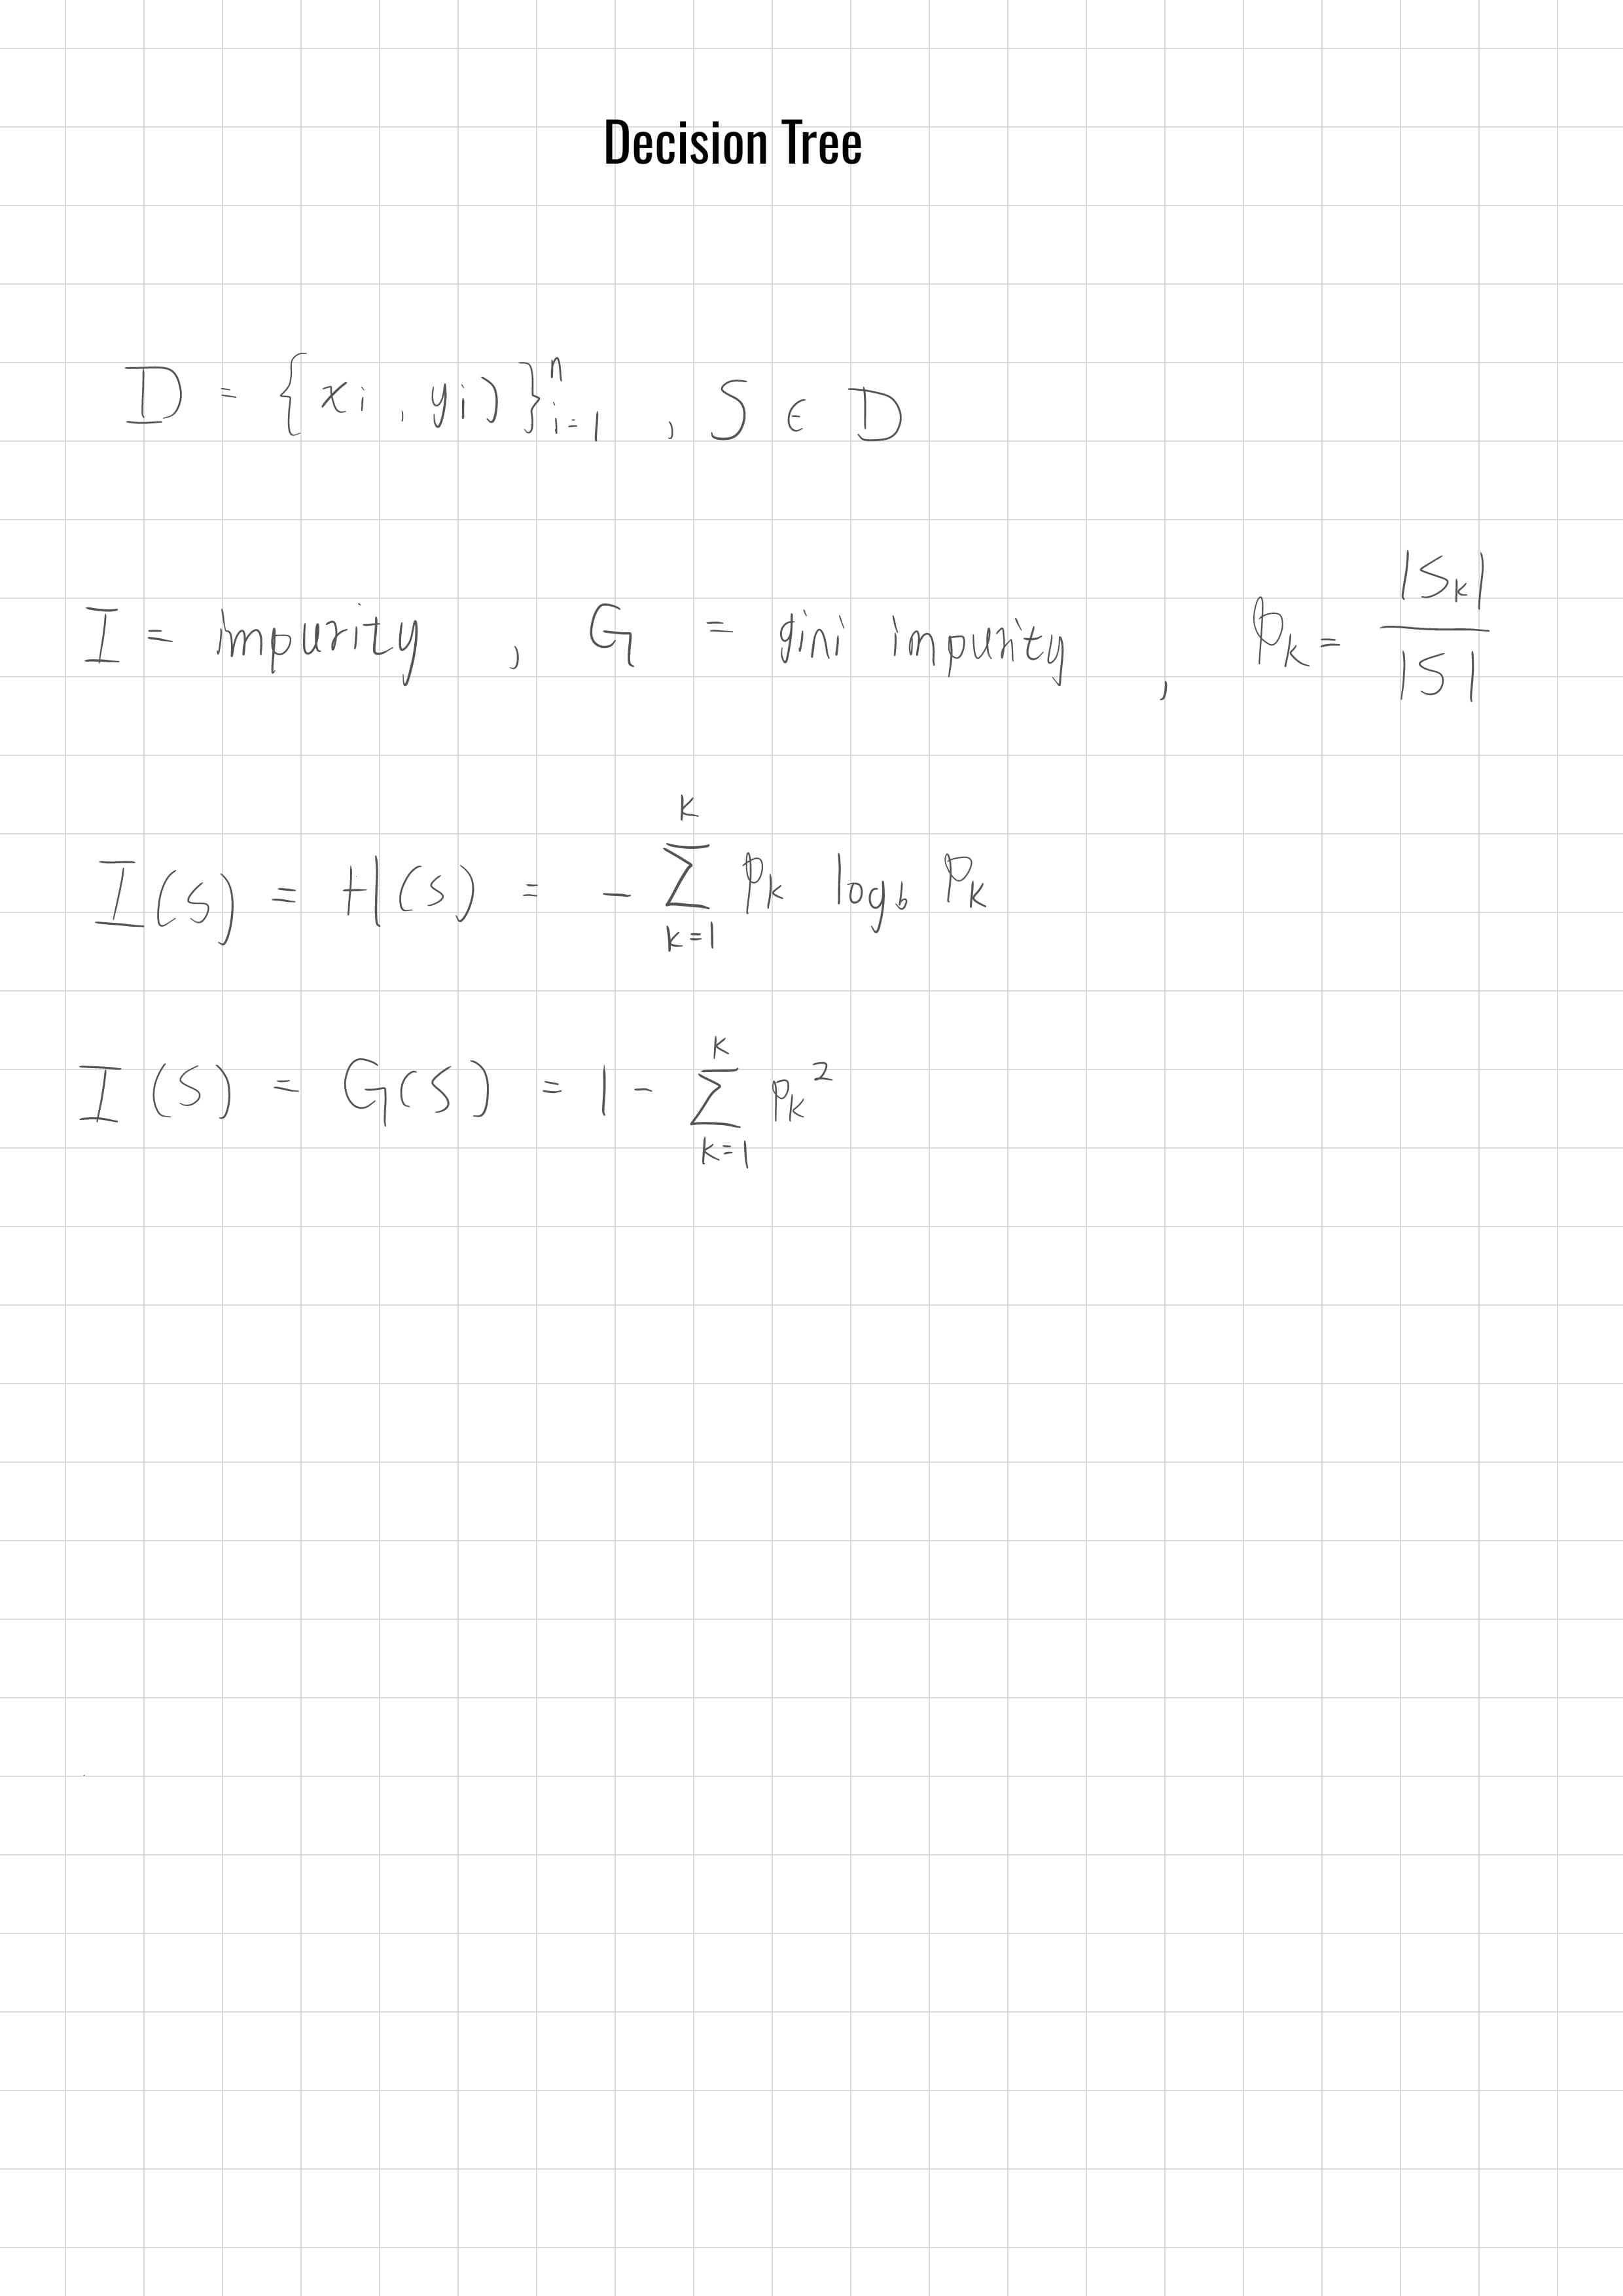決策樹分類(Decision Tree Classifier)實驗
此實驗決策樹模型基於 ID3(Iterative Dichotomiser 3)演算法,並以自行實作方式完整掌握資料分割、不純度計算、分裂特徵選擇與樹狀結構生成流程,從而避免現成套件所帶來的黑箱化問題,使模型行為與實驗結果可以被清楚追蹤與分析。
決策樹資料結構
Node 類別是決策樹的基本結構單位,在樹的建構過程中會調用此類別來完成節點創建
class Node:
    def __init__(self, attribute=None, branches=None, value=None, samples=0):
        self.attribute = attribute
        self.branches = branches or {}
        self.value = value
        self.samples = samples
-
attribute:表示當前分裂依據的特徵 -
branches:特徵值對應的子節點集合 -
value:葉節點預測類別 -
samples:節點所含樣本數
DecisionTree 類別,負責整體訓練與推論流程。模型以資料集中預先指定之特徵集合與目標標籤作為輸入,並透過設定分裂準則與最大樹深度等參數,控制決策樹的建構行為。
class DecisionTree:
    def __init__(
        self,
        features,
        target,
        criterion="entropy",
        max_depth=10
    ):
分裂準則(Split Criterion)與不純度計算(Impurity)
節點品質以目標標籤分佈之不純度(impurity)作為衡量依據,模型支援資訊熵(Entropy)、基尼不純度(Gini Impurity)兩種不純度計算,並透過 _impurity 作為統一介面,對外隱藏準則細節。
    def _impurity(self, data):
        if self.criterion == "entropy":
            return self._entropy(data)
        elif self.criterion == "gini":
            return self._gini(data)
最佳特徵選擇(Best Split)
在當前節點對所有尚未使用的特徵計算資訊增益(Information Gain),選擇資訊增益最大的特徵作為分裂依據,這是貪婪策略(Greedy Strategy),僅考慮當前節點的最佳分裂。
    def _best_split(self, data, attributes):
        gains = {
            attr: self._information_gain(data, attr)
            for attr in attributes
        }
        best_attr = max(gains, key=gains.get)
        return best_attr, gains[best_attr]
決策樹建構流程
決策樹的建構採用遞迴方式進行,每一次遞迴呼叫皆負責將當前資料子集轉換為一個對應的節點(Node)。在遞迴過程中,演算法會依據資料標籤分佈、可用特徵集合與樹深度限制,並判斷是否終止分裂並生成葉節點,如未觸發限制條件,並且仍滿足分裂條件,則選擇最佳特徵建立決策節點,並對各特徵取值遞迴生成子樹。所有節點最終透過遞迴回傳逐層組裝,形成完整的決策樹結構。
def _build_tree(self, data, attributes, depth):
Step 1:取得當前節點的標籤分佈
從目前節點所對應的資料子集取出目標變數(labels),作為是否停止分裂的判斷依據。
labels = data[self.target]
Step 2:純度檢查(Pure Node)
若所有樣本的標籤皆相同,則建立一個葉節點(Leaf Node),其預測值為該唯一標籤,並結束遞迴。
if labels.nunique() == 1:
    return Node(value=labels.iloc[0], samples=len(data))
Step 3:停止條件檢查(Stopping Criteria)
若已無可用特徵,或當前深度已達最大深度限制,則建立葉節點,其預測值為目前資料集中出現次數最多的標籤(majority vote)。
if not attributes or depth >= self.max_depth:
    return Node(value=labels.mode()[0], samples=len(data))
Step 4:D選擇最佳分裂特徵
在尚可使用的特徵集合中,計算每個特徵的分裂效益(如資訊增益),並選擇效益最高者作為當前節點的分裂屬性。
best_attr, gain = self._best_split(data, attributes)
Step 5:無效分裂判斷
若最佳分裂特徵的效益為 0,代表任何分裂皆無法提升分類能力,則建立葉節點,並以多數類別作為預測結果。
if gain == 0:
    return Node(value=labels.mode()[0], samples=len(data))
Step 6:建立內部節點(Decision Node)
以選定的最佳特徵建立決策節點,並將該特徵自後續遞迴可用的特徵集合中移除。
node = Node(attribute=best_attr, samples=len(data))
remaining_attrs = [a for a in attributes if a != best_attr]
Step 7:依特徵取值進行分支
針對該分裂特徵的每一個可能取值,擷取對應的資料子集,並以更新後的特徵集合與深度進行遞迴建構。
for value in data[best_attr].unique():
    subset = data[data[best_attr] == value]
    node.branches[value] = self._build_tree(
        subset,
        remaining_attrs,
        depth + 1
    )
Step 8:回傳當前子樹
當所有分支皆完成建構後,回傳當前節點,供上一層遞迴物件,最終回傳完整決策樹。
模型訓練
模型透過 fit 方法於訓練資料上建立決策樹結構,最終產生一個以 Node 物件遞迴組裝而成的樹狀模型,其根節點儲存在 tree.root。
tree.fit(train_data)
模型預測
在預測階段,模型自根節點開始進行推論,依據樣本於各節點所對應之特徵取值,遞迴地沿著相符的分支向下搜尋,直到抵達葉節點並輸出其預測標籤
def _predict_one(self, node, sample):
模型評估
模型效能以分類準確率(accuracy)作為主要評估指標。評估流程中,首先對測試資料進行整體預測,取得模型對每一筆樣本的預測標籤,再與資料集中對應的實際標籤逐筆比較。當預測結果與實際標籤相同時,視為一次正確分類。最終以正確分類樣本數除以測試樣本總數,作為模型在測試資料上的整體表現量化指標。
y_pred = tree.predict(test_data)
y_true = test_data[DatasetSchema.TARGET].tolist()
total = len(y_true)
correct = sum(t == p for t, p in zip(y_true, y_pred))
accuracy = correct / total
實驗
資料描述
本研究使用一份購買行為資料集,用以描述個體在多項類別型屬性條件下是否進行產品購買,並作為監督式學習中決策樹模型的訓練與評估依據。
=== First 5 Records ===
           Age  Income Student Credit_Rating Buys_Product
0  Middle-aged     Low      No          Fair           No
1          Old  Medium      No          Fair           No
2          Old     Low      No     Excellent           No
3  Middle-aged    High     Yes     Excellent          Yes
4        Young  Medium     Yes     Excellent          Yes

=== Dataset Schema ===
Features: ['Age', 'Income', 'Student', 'Credit_Rating']
Target: Buys_Product
-
Age:年齡區間的類別型特徵(Young / Middle-aged / Old)
-
Income:收入水準的類別型特徵(Low / Medium / High)
-
Student:是否為學生的類別型特徵(Yes / No)
-
Credit Rating:信用評等的類別型特徵(Fair / Excellent)
-
Buys_Product:目標(輸出)變數,表示是否購買產品(Y / N)
資料結構定義與驗證
透過 DatasetSchema 類別集中管理特徵與目標欄位,避免硬編碼錯誤,並在實驗前檢查資料完整性,並於模型訓練前執行基本的資料結構驗證,例如欄位檢查,遺失值排查等等
class DatasetSchema:
    FEATURES = ['Age', 'Income', 'Student', 'Credit_Rating']
    TARGET = 'Buys_Product'
    @classmethod
    def validate(cls, df, head_n=5, info=False):
	    ...
        return True
資料分割與隨機性控制
資料集以 80% / 20% 比例切分為訓練集與測試集,並透過可設定的隨機種子參數固定資料分割結果,使不同實驗之間能在相同資料切分條件下進行對照,降低隨機性對決策樹結構與評估結果的干擾,並提升實驗的可重現性。
    @classmethod
    def split(
        cls,
        df,
        test_size=0.2,
        random_state=None,
        shuffle=True,
        verbose=False
    ):
	    ...
        return train_data, test_data
決策樹流程
決策樹採用 entropy 作為分裂準則,以資訊增益(information gain)決定每一層節點的最佳分裂特徵,訓練完成後,模型內部形成一棵完整的決策樹,用以表示特徵分裂與預測決策之關係。
模型訓練完成後,決策樹結構將固定,並作為後續預測與分析的依據。為支援實驗紀錄與可重現性分析,實驗中將訓練完成的決策樹轉換為結構化表示,用以保存節點層級、分裂條件、樣本數量與分支關係等資訊。
預測與評估流程
在測試階段,模型對每一筆測試樣本自根節點開始,依其特徵值沿既有的決策樹結構向下進行條件判斷,直到抵達葉節點,並以該葉節點所儲存之標籤作為預測結果。
實驗中逐筆輸出測試樣本的特徵組合、實際標籤與模型預測結果,以檢視模型在不同條件下的判斷行為。
整體效能以 Accuracy(準確率) 作為評估指標,統計正確與錯誤分類的樣本數量,作為模型分類能力的量化依據。
實驗紀錄
實驗同時記錄以下關鍵資訊以利重現與分析,此紀錄方式確保實驗結果具備可追蹤性與可重現性,並可作為後續比較不同設定或模型變體的基礎。
視覺化分析 決策樹模型可進行可視化,以觀察模型實際採用的決策路徑與分裂邏輯。
結構紀錄 透過 JSON 格式保存決策樹結構,作為實驗 log 與後續比對、重現之輔助資料。
紀錄資料
- 實驗種子碼與時間戳記
- 分裂準則與最大樹深設定
- 使用之特徵與目標標籤
- 資料集切分比例與樣本數
- 評估結果(正確數、錯誤數、準確率)
- 完整決策樹結構(JSON)
結果
小型資料集
本次實驗首先使用包含 30 筆樣本的資料集訓練決策樹模型,資料集依照 80% 作為訓練資料、20% 作為測試資料進行分割
=== Dataset Split Info ===
Total Samples: 30
Training Samples: 24 (80%)
Testing Samples: 6 (20%)
在隨機種子 SEED:1766988597 的設定下,利用訓練資料進行決策樹的建構,在6筆樣本的測試預測下,準確度表現只有 Accuracy: 0.5000 ,儘管整體準確率偏低,此結果在小樣本情境下仍具有分析價值

Index=3 | Age=Middle-aged, Income=High, Student=Yes, Credit_Rating=Excellent → Actual=Yes, Predicted=No ✗
Index=29 | Age=Young, Income=Medium, Student=No, Credit_Rating=Excellent → Actual=No, Predicted=No ✓
Index=13 | Age=Old, Income=High, Student=Yes, Credit_Rating=Fair → Actual=No, Predicted=No ✓
Index=27 | Age=Old, Income=Low, Student=Yes, Credit_Rating=Excellent → Actual=No, Predicted=Yes ✗
Index=25 | Age=Old, Income=Low, Student=No, Credit_Rating=Fair → Actual=No, Predicted=No ✓
Index=2 | Age=Old, Income=Low, Student=No, Credit_Rating=Excellent → Actual=No, Predicted=Yes ✗

=== Evaluation Summary ===
Total Test Samples : 6
Correct Predictions: 3
Incorrect Predictions: 3
Accuracy: 0.5000 (3/6)
這是資料分割後的訓練資料 SEED:1766988686 所訓練出來的決策樹結構,此次的表現的表現為Accuracy: 1.0000 <span class="paren">(6/6)</span>

Index=26 | Age=Old, Income=Medium, Student=No, Credit_Rating=Fair → Actual=No, Predicted=No ✓
Index=24 | Age=Middle-aged, Income=Low, Student=Yes, Credit_Rating=Excellent → Actual=No, Predicted=No ✓
Index=4 | Age=Young, Income=Medium, Student=Yes, Credit_Rating=Excellent → Actual=Yes, Predicted=Yes ✓
Index=9 | Age=Middle-aged, Income=Medium, Student=No, Credit_Rating=Excellent → Actual=No, Predicted=No ✓
Index=6 | Age=Middle-aged, Income=Low, Student=No, Credit_Rating=Excellent → Actual=No, Predicted=No ✓
Index=17 | Age=Old, Income=Low, Student=Yes, Credit_Rating=Fair → Actual=No, Predicted=No ✓

=== Evaluation Summary ===
Total Test Samples : 6
Correct Predictions: 6
Incorrect Predictions: 0
Accuracy: 1.0000 (6/6)
決策樹的分裂準則在給定訓練資料下是確定且一致的,它在每個節點以貪婪方式尋找該資料子集合上的局部最優分裂,但在樣本數少量的情況下,順練資料的變動很容易產生不純度估計的計算改變,從而改變了樹的結構,影響了決策的關鍵節點
從這個結果來看,最先比較的差異在根節點的改變,在 SEED:1766988597 實驗中,我們看到它使用Age 作為根節點,而在 SEED:1766988686 實驗中則是 Income
回到剛剛 SEED:1766988597 實驗中,從以下預測錯誤的三筆資料可以觀察出,Income=High 實際為 Actual=Yes ,而 Income=Low 則為 Actual=No
Index=3 | Age=Middle-aged, Income=High, Student=Yes, Credit_Rating=Excellent → Actual=Yes, Predicted=No ✗
Index=27 | Age=Old, Income=Low, Student=Yes, Credit_Rating=Excellent → Actual=No, Predicted=Yes ✗
Index=2 | Age=Old, Income=Low, Student=No, Credit_Rating=Excellent → Actual=No, Predicted=Yes ✗
從整體實驗結果可觀察到,決策樹根節點的選擇高度依賴於訓練資料中類別分佈的穩定性。在小樣本資料集中,不同隨機切分(SEED)會顯著改變各特徵對目標變數的不純度貢獻,使得原本資訊增益相近的特徵(如 Age 與 Income)在不同實驗中交替成為根節點,進而放大早期分裂差異對整體樹結構與預測結果的影響。
中型資料集
本次實驗首先使用包含1000筆樣本的資料集訓練決策樹模型,資料集依照 80% 作為訓練資料、20% 作為測試資料進行分割,中型資料集共有三份資料集作為實驗,稱為A-1000、B-1000、C-1000
=== Dataset Split Info ===
Total Samples: 1000
Training Samples: 800 (80%)
Testing Samples: 200 (20%)
A-1000 資料集實驗
當前使用 A-1000 資料集,在 SEED:1767002878 實驗中,我們得到了 Accuracy: 0.9500 <span class="paren">(190/200)</span> 預測結果,這個決策樹結構為 Age 作為根節點。在先前我們在小型資料集中的推論為Income 是一個優先影響的決策節點,這是一個重要的觀察切入點。

=== Evaluation Summary ===
Total Test Samples : 200
Correct Predictions: 190
Incorrect Predictions: 10
Accuracy: 0.9500 (190/200)
B-1000 資料集實驗
 當前使用 B-1000 資料集,在
SEED:1767003177 實驗中,我們得到了 Accuracy: 0.9450 <span class="paren">(189/200)</span> 評估結果,這個決策樹結構仍是 Age 作為根節點,並且可以注意到樹在寬度與深度上皆呈現高度展開的結構,而準確率確與。
=== Evaluation Summary ===
Total Test Samples : 200
Correct Predictions: 189
Incorrect Predictions: 11
Accuracy: 0.9450 (189/200)
C-1000 資料集實驗

當前使用 C-1000 資料集,在 SEED:1767003303 實驗中,我們得到了 Accuracy: 1.0000 <span class="paren">(200/200)</span> 預測結果,這個決策樹結構為 Income 作為根節點,以及在分支 Income:High 進行分裂,他的子節點為 Credit_Rating ,在節點 Credit_Rating:Excellent 族群中,預測購買占比高達 136,這顯示了這個決策路徑的重要性
此次實驗顯示具有影響力的決策路徑為:
- 高收入
Income:High - 優秀的信用卡信譽
Credit_Rating:Excellent
因此,在 C-1000 資料集中出現優秀準確率(Accuracy = 1.0),且樹結構深度相對較淺,顯示資料中特徵與目標之間存在高度一致的決策規則,使模型能在早期節點完成有效區分。從結果可推測該資料集的類別可分性(class separability)可能高於其他兩組資料,而非僅是模型過度擬合所導致。
=== Evaluation Summary ===
Total Test Samples : 200
Correct Predictions: 200
Incorrect Predictions: 0
Accuracy: 1.0000 (200/200)
總結
在小樣本情境下,決策樹由於各節點可用樣本數有限,不純度估計(如 Gini impurity 或 entropy)呈現高度不穩定,使得早期分裂的選擇對資料分割結果極為敏感。這種不穩定性會在樹的上層結構被放大,進而導致整體樹形與最終預測結果產生顯著差異。
即便如此,本次小型資料集實驗仍顯示,在部分資料切分下,收入因素(Income)可能作為關鍵特徵,在早期節點發揮主要決策作用。
隨著樣本數增加,重要特徵能在較淺層完成有效區分,降低單一分裂對整體結構的影響,使決策樹在深度與分支配置上同時趨於穩定。結果顯示資料規模對於決策樹分裂策略的穩定性與模型泛化能力具有關鍵影響。
參考資料
[1] GeeksforGeeks, “Iterative Dichotomiser 3 (ID3) Algorithm From Scratch,” GeeksforGeeks, Jan. 02, 2024. https://www.geeksforgeeks.org/machine-learning/iterative-dichotomiser-3-id3-algorithm-from-scratch/
[2] GeeksforGeeks, “CART (Classification And Regression Tree) in Machine Learning,” GeeksforGeeks, Sep. 23, 2022. https://www.geeksforgeeks.org/machine-learning/cart-classification-and-regression-tree-in-machine-learning/
[3] GeeksforGeeks, “Decision Tree Algorithms,” GeeksforGeeks, Nov. 11, 2023. https://www.geeksforgeeks.org/machine-learning/decision-tree-algorithms/