模型泛化(Generalization)策略

摘要
泛化能力(generalization)指模型在未見過資料(unseen data)上的表現能力。機器學習(machine learning)與深度學習(deep learning)的核心目標並非單純提升訓練集準確率,而是在未知資料上維持穩定且可靠的預測能力。
當模型過度擬合(overfitting)訓練資料時,模型會逐漸學習資料中的噪聲(noise)與偶然模式(spurious patterns),導致訓練表現持續提升,但驗證集(validation set)與測試集(test set)表現下降。此現象代表模型對資料形成過度依賴,而缺乏對真實分佈(data distribution)的穩定理解。
因此,提升泛化能力的核心並非單純提高模型容量(model capacity),而是控制模型如何學習資料中的結構。實務上常透過模型約束(regularization)、訓練穩定化(training stabilization)、資料擴增(data augmentation)與模型容量控制(capacity control)等方式降低模型對局部模式與訓練噪聲的敏感度。
從更一般的角度來看,泛化問題本質上反映模型如何在記憶資料與學習結構之間取得平衡,而不同泛化方法則代表不同的結構假設(structural assumptions)與歸納偏好(inductive biases)。
模型約束與正則化(Regularization)
正則化(regularization)的核心目的是限制模型複雜度(model complexity),降低模型對特定特徵與局部模式的依賴,使模型傾向學習較穩定的表示(stable representations)。
L1 正則化(L1 regularization)會促使部分權重變為零,因此具有稀疏化(sparsity)與特徵選擇(feature selection)效果。
keras.layers.Dense(
    kernel_regularizer=keras.regularizers.l1()
)
L2 正則化(L2 regularization)則限制權重大小,使模型形成較平滑(smooth)的參數分佈,是最常見的正則化方法之一。
keras.layers.Dense(
    kernel_regularizer=keras.regularizers.l2()
)
Elastic Net 結合 L1 與 L2 的特性,同時兼具稀疏化與權重約束能力。
keras.layers.Dense(
    kernel_regularizer=keras.regularizers.l1_l2()
)
Dropout 則透過訓練期間隨機移除部分神經元,避免模型過度依賴固定路徑(fixed pathways)。
keras.layers.Dropout(0.1)
此方法能迫使模型學習更具魯棒性(robustness)的特徵表示,因此在深度神經網路中廣泛使用。
訓練穩定化方法(Training Stabilization)
部分方法的主要作用並非限制模型複雜度,而是穩定訓練動態(training dynamics)與改善梯度傳播(gradient flow)。
Batch Normalization(BN)透過標準化每層輸出的分佈,使模型在訓練過程中維持較穩定的數值尺度(numerical scale),從而加速收斂並改善訓練穩定性。
keras.layers.Dense(),
keras.layers.BatchNormalization()
雖然 Batch Normalization 在實務上常具有類似正則化的效果,但其核心本質仍屬於數值分佈穩定化(distribution stabilization),而非直接限制模型解空間。
Early Stopping 則透過監控驗證損失(validation loss)避免模型持續擬合訓練噪聲。
from tensorflow.keras.callbacks import EarlyStopping

early_stop = EarlyStopping(
    monitor='val_loss',
    patience=3,
    restore_best_weights=True
)
當驗證表現不再改善時提前停止訓練,可有效降低後期過擬合現象。
資料分佈擴展(Data Augmentation)
資料擴增(data augmentation)透過對原始資料進行隨機變換,增加訓練資料的多樣性(data diversity),使模型學習更具普遍性的特徵。
在影像任務中,常見方法包含旋轉(rotation)、平移(translation)與翻轉(flipping)。
from tensorflow.keras.preprocessing.image import ImageDataGenerator

datagen = ImageDataGenerator(
    rotation_range=20,
    width_shift_range=0.1,
    height_shift_range=0.1,
    horizontal_flip=True
)
此類方法本質上是在擴展資料分佈(data distribution),而非直接修改模型本身。
模型容量控制(Model Capacity Control)
模型容量(model capacity)越高,越容易擬合複雜模式,同時也越容易學習資料中的噪聲。
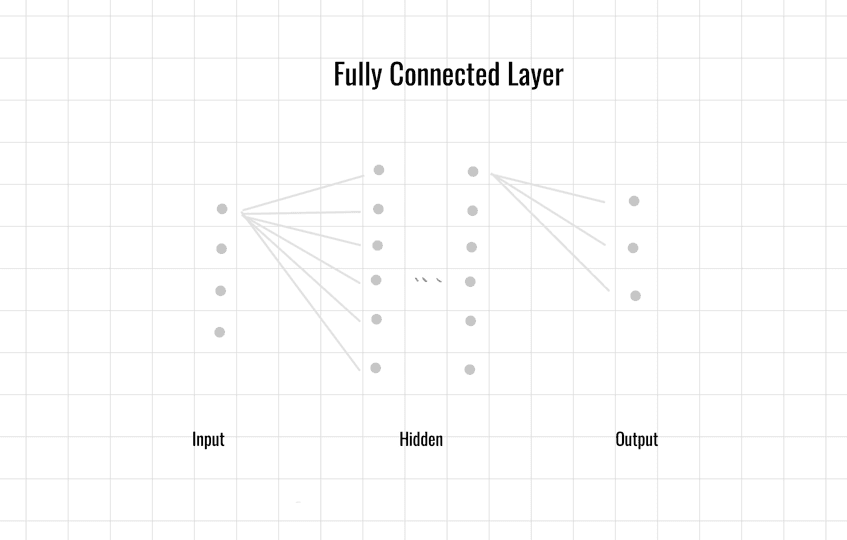
降低隱藏層數量、減少神經元數目或縮小模型規模,皆屬於模型容量控制方法。此類方法透過限制模型可表示的函數空間(function space),降低過擬合風險。
因此,泛化能力的提升通常並非依賴單一技巧,而是同時從模型結構、訓練動態與資料分佈三個層面共同控制模型行為。